前言
当 AI 大模型迈入十万亿参数时代,单颗英伟达 Rubin GPU 功耗突破2300W,单机柜功率密度飙升至350kW,传统风冷在热流密度、温控精度、能耗效率上已全面触顶。英伟达以全栈液冷技术构建从芯片级、系统级到数据中心级的完整热管理闭环,以45℃温水冷却、微通道冷板、无风扇全液冷、去冷机化四大核心突破,重新定义 AI 算力基础设施的散热标准。本文以深度技术解析 + 官方实拍图 + 结构原理图的形式,完整呈现英伟达液冷技术体系。
一、技术演进:从风冷妥协到全液冷革命的三代跃迁
英伟达液冷技术伴随算力爆炸完成三次战略升级,从选配方案成为 AI 算力刚性标配:
1.1 萌芽期(2022 年前):风冷为主,液冷选配
- 散热方案:传统风冷 + 定制化液冷选配,液冷仅覆盖 GPU 核心,热覆盖率 < 50%
- 局限:高负载频繁降频,PUE≥1.3,无法支撑高密度集群1.2 发展期(2023-2025,Blackwell 架构):液冷优先,混合散热
- 散热方案:冷板式直触液冷为主,覆盖 80%-90% 热源(GPU、CPU、NVLink),电源、存储保留少量风冷
- 功率突破:GB300 单 GPU 1400W,单机柜 128-132kW,PUE 降至 1.1 左右
- 核心特征:冷板独立设计,多芯片分立式散热,引入 CDU 冷却分配单元
1.3 成熟期(2026 年起,Vera Rubin 架构):100% 全栈液冷,无风扇化
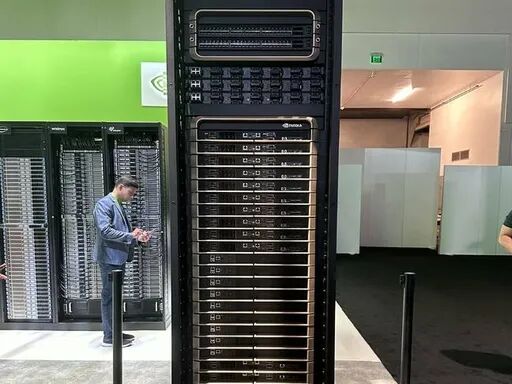
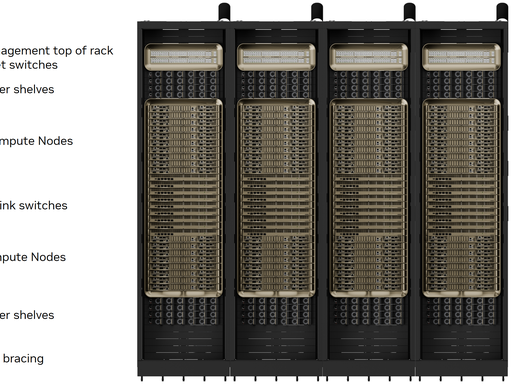
- 散热方案:全液冷全覆盖,取消所有风扇、软管、冗余线缆,GPU/CPU/NVLink 交换机 / 光模块全组件液冷
- 极限功率:单 GPU 2300W,单机柜≥350kW,PUE 低至 1.05-1.08
- 革命设计:三无架构(No Fans/No Hoses/No Cables)、一体化大冷板、微通道 MLCP 技术
二、芯片级液冷:微通道冷板 + 超低阻热路径,突破热流密度极限
针对 2300W 芯片的极端热流密度(>150W/cm²),英伟达从材料、结构、界面三层重构底层散热体系。
2.1 MLCP 微通道液冷板:芯片级散热核心
技术定义:Micro-Channel Liquid Cooling Plate(MLCP),将封装盖与冷板一体化,内置50-200μm微米级流道网络。核心优势:
- 传热路径从 5 层(芯片→TIM→盖→均热板→冷板→流体)压缩至 2 层(芯片→微通道流体),总热阻降至 0.03℃・cm²/W,降低 70%
- 换热面积提升 10 倍,散热能力达2500W / 芯片,热流密度突破 500W/cm²
- 材质:99.99% 高纯度铜(导热系数 400W/m・K),真空钎焊 + 激光蚀刻工艺
2.2 热界面材料(TIM):液态金属 + 高导凝胶双路线
- 液态金属 TIM(信越 X 系列):导热系数 >40W/m・K,热阻 < 0.05℃・cm²/W,10 年无干化、无腐蚀
- 高导凝胶 TIM:适配振动场景,压缩率 30%-50%,界面接触率≥95%
- 应用:Rubin 芯片与 MLCP 冷板间直触填充,消除空气间隙热阻
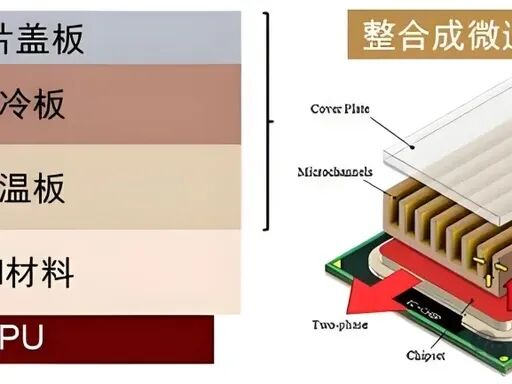
2.3 芯片级热设计:倒装焊 + 均热层 + 热点抑制
- 封装结构:FC-BGA 倒装焊 + 硅中介层 + 超薄均热板,热扩散路径缩短 80%
- 热点控制:芯片核心区嵌入铜柱阵列,热点温差 < 5℃,避免局部过热触发功耗墙
- 温控精度:±1℃ 级精准控温,芯片稳定在 45-55℃最佳区间
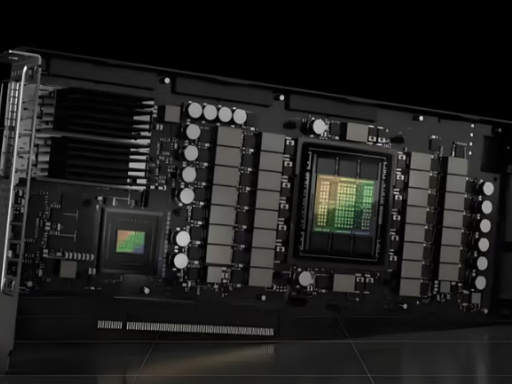
三、系统级液冷:三无模块化架构,重构服务器散热形态
Vera Rubin 平台以去风扇、去软管、去线缆的三无设计,实现系统级液冷最优解,彻底解决大规模部署的可靠性与维护痛点。
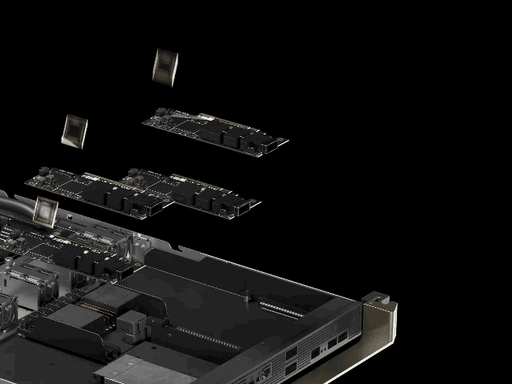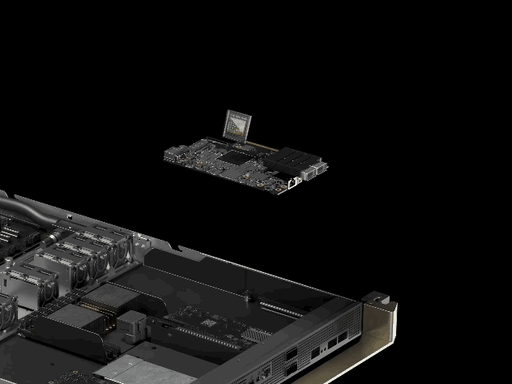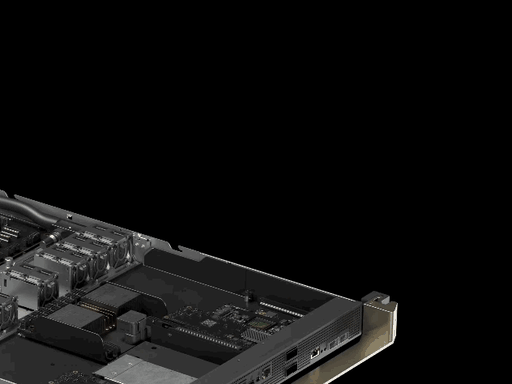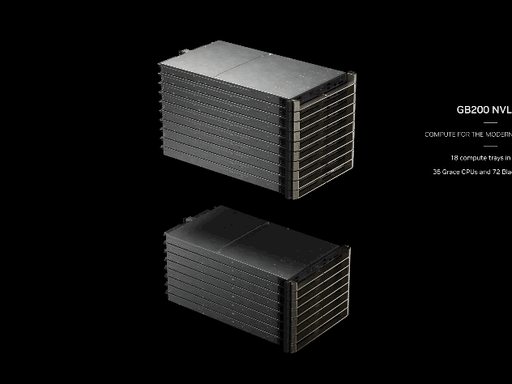
3.1 无风扇全液冷:100% 热源覆盖
- 取消所有服务器风扇,消除 15%-20% 风扇寄生功耗,算力利用率提升 10%
- 液冷覆盖清单:Vera CPU、Rubin GPU、NVLink6 交换机、Spectrum-X 交换机、BlueField-4 DPU、OSFP 光模块
- 噪音:从 85dB 降至45dB 以下,机房环境彻底优化
3.2 无软管硬连接:歧管 + 盲插快拆(UQD)
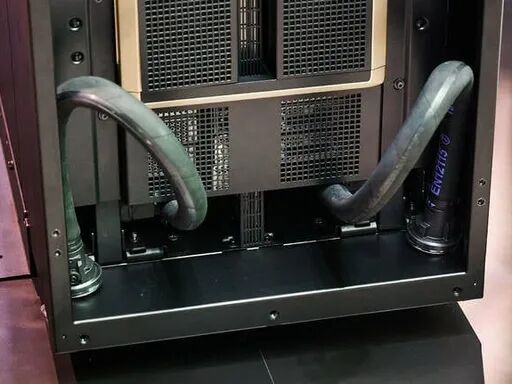
- 抛弃 EPDM 橡胶软管,采用内部液体歧管 + NVQD03 盲插接头
- 维护效率:服务器插拔时间从100 分钟→6 分钟,效率提升 18 倍
- 可靠性:消除软管老化、震动泄漏风险,系统 MTBF>100 万小时
 3.3 无线缆化:集成化布线 + 冷板空间优化
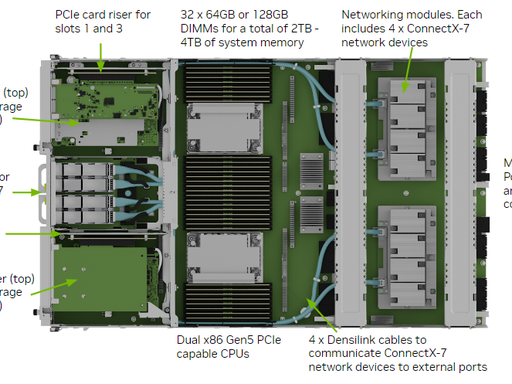
- 重构内部布线,取消冗余线缆,为冷板、流道预留 **30%** 额外空间
- 供电:800V 高压直流 + 母线盲插,减少线缆损耗,适配 350kW 机柜功率
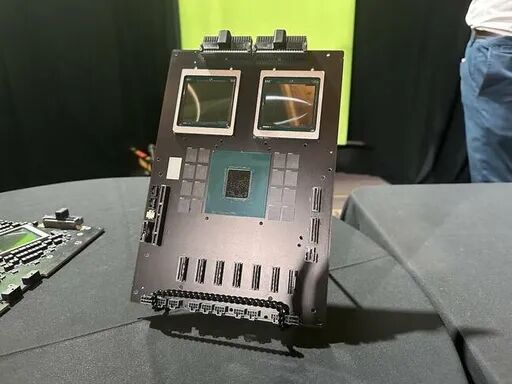
3.4 一体化大冷板:1 板覆盖 1CPU+2GPU
- 放弃 GB300 “单芯片单冷板” 设计,采用一体化大冷板,同时覆盖 1 颗 Vera CPU+2 颗 Rubin GPU
- 优势:减少 40% 流体接头,流阻降低 30%,温度均匀性提升至 < 3℃
四、机柜级液冷:CDU + 流体分配,构建兆瓦级散热集群
4.1 CDU 冷却分配单元:液冷系统的 “心脏”
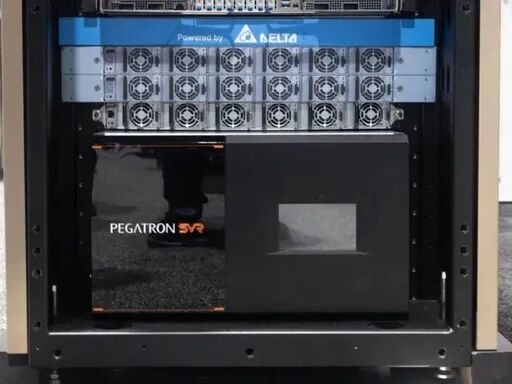
- 核心功能:冷却液循环、压力 / 流量 / 温度调控、泄漏检测、冷热侧隔离换热
- 流量精度:±2%,单 GPU 流量 4.5L/min
- 介质:水 + 乙二醇(30%)+ 缓蚀剂,适用 - 20℃~60℃环境
4.2 流体分配网络:并联 + 精准控流
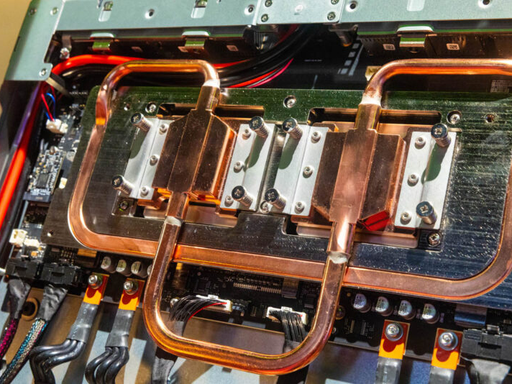
- 架构:机柜级主歧管→刀片级分液器→芯片冷板三级并联分配
- 控制:每个冷板配流量调节阀,根据芯片负载动态调节,避免流量不均
- 压降:系统总压降 < 1.5bar,降低 CDU 泵功耗
4.3 机柜架构:Rubin NVL72 全液冷机柜
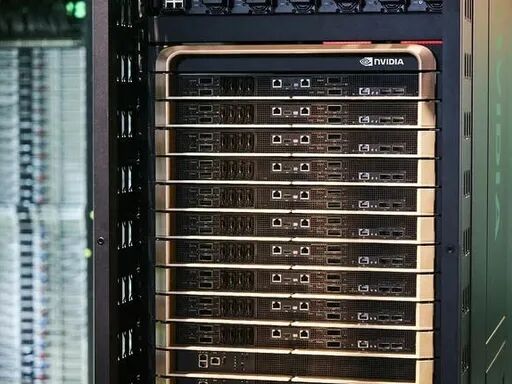
- 规格:42U 标准机柜,内置 18 个计算托盘 + 9 个 NVLink 交换机托盘NVIDIA
- 功率:Max-P 模式350kW / 柜,重量 1.8 吨
- 部署:支持兆瓦级 AI 工厂集群,40 机柜组成 1Pod,总功率 14MW
五、数据中心级液冷:45℃温水冷却 + 去冷机化 + 余热回收
5.1 45℃温水冷却:颠覆传统低温制冷逻辑
- 进水温度标准:45℃±2℃(传统风冷 / 液冷 7-15℃)
- 去冷机化(Chiller-less):无需冷水机组,直接通过干冷器 + 自然冷却散热
- 能效:冷却能耗降低70%,数据中心 PUE 稳定 1.05-1.08
5.2 冷热回路隔离:安全 + 高效双重保障
- 双回路设计:IT 侧封闭回路(乙二醇水溶液)+ 机房侧冷却回路(纯水)
- 隔离换热:通过 CDU 内部板换器换热,杜绝冷却液泄漏风险,保护 IT 设备
5.3 余热回收:绿色算力闭环
- 回收效率:液冷余热85% 可回收,温度 40-45℃适配园区供暖、生活热水、工业预热
- 案例:谷歌 GB300 集群余热供暖,年节省电费超120 万美元
六、生态与标准:开放架构 + 产业协同,加速液冷普及
6.1 主导行业标准:SFF-TA-1001 液冷接口规范
- 统一冷板尺寸、快插接头、流道接口、CDU 通信协议
- 解决兼容性痛点,降低 ODM/OEM 厂商开发门槛,液冷产品上市周期缩短50%
6.2 全球生态伙伴:全产业链协同
- 冷板 / CDU:Vertiv、施耐德、CoolIT、英维克、申菱环境
- 制造:富士康、鸿佰、和硕、广达(液冷服务器 ODM)
6.3 MGX 模块化参考设计
- 合作伙伴可快速定制液冷方案,适配 GB300、Rubin 全平台
七、技术价值:算力、能效、成本的三维重构
7.1 算力性能跃升
- 无降频运行:GPU 持续满功耗输出,大模型训练速度 +15%-20%,推理延迟-30%
- 密度提升:单机柜算力 ×3,同等算力占地 -75%
7.2 能效与 TCO 优化
- 能耗:数据中心年能耗 -25%,大型集群年省电费超千万美元
- 成本:液冷前期投资高 35%,但1.5 年回收成本,5 年 TCO-20%
7.3 产业格局重塑
- 液冷从 “选配” 变为 AI 算力刚需,2026 年全球 AI 液冷市场 ≥170 亿美元 ,年增速 50%+
- 技术壁垒提升,具备微通道、高精度 CDU 研发能力的头部企业主导市场
八、未来展望:浸没式 + CPO+AI 热管理的下一代突破
- 浸没式液冷规模化2027 年 Rubin Ultra 平台采用两相浸没液冷,单机柜功率600kW+
- CPO + 液冷深度融合
- 为 Spectrum-X CPO 交换机光模块精准散热,支撑1.6Tbps超高速互联
- AI 智能热管理大模型预测芯片发热,动态调节流量 / 温度,散热效率再 +15%
结语
英伟达全栈液冷并非单一散热技术升级,而是从芯片材料、系统架构到数据中心基础设施的全维度革命。以45℃温水冷却、微通道 MLCP、三无模块化、去冷机化为核心,彻底破解 AI 算力爆发的热管理瓶颈,推动数据中心从 “风冷时代” 全面迈入液冷原生时代。随着 Vera Rubin 平台 2026 年 Q3 大规模交付,全栈液冷将成为支撑 AGI、超算、云计算的核心基础设施,重塑全球算力产业格局。